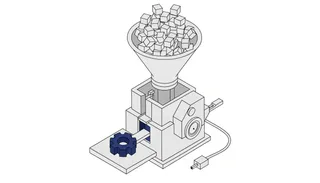
- Машинное обучение — способ получить программу не из правил, написанных человеком, а из примеров.
- Результат обучения называют моделью: это математическая зависимость, найденная в данных.
- Основные виды обучения: с учителем, без учителя и с подкреплением; от вида зависит, какие данные нужны.
- Модель проверяют на данных, которых она не видела: иначе легко принять заучивание за понимание.
Содержание8 разделов ▾
Машинное обучение — это способ получить программу не из правил, которые написал человек, а из примеров: алгоритм сам подбирает правила по данным. Статья для тех, кто знает, что такое нейросеть, и хочет увидеть картину шире: какие бывают виды обучения, как отличить хорошую модель от плохой и зачем нужна проверка.
Опираемся на вводный курс Google по машинному обучению, учебник Школы анализа данных Яндекса и книгу «Deep Learning» Гудфеллоу, Бенджио и Курвилля. Пример на Python запускался на версии 3.13, данные на октябрь 2026 года.
Чем это отличается от обычной программы
Обычная программа работает по инструкции: разработчик описывает каждый шаг. Для задачи вроде «определить, будет ли дождь» это очень трудно. Google в своём курсе показывает два пути. Первый — построить физическую модель атмосферы и решать огромное число уравнений. Второй — дать модели большие массивы данных о погоде, чтобы она сама нашла связь между погодными условиями и количеством осадков. Затем в готовую модель подают текущую погоду, и она предсказывает осадки. Модель подбирает параметры по ошибкам, и чаще всего для этого используют градиентный спуск.
Из чего состоит машинное обучение
Любая система машинного обучения опирается на одни и те же части:
- Данные, на которых модель учится.
- Модель — математическая зависимость, которая превращает признаки в ответ.
- Способ измерять ошибку, то есть насколько ответ модели отличается от верного.
- Алгоритм обучения, который подправляет модель, чтобы ошибка стала меньше.
- Проверка на данных, которых модель не видела.
Соотношение с соседними понятиями показывает диаграмма из книги Гудфеллоу, Бенджио и Курвилля. Глубокое обучение — вид обучения представлений, а оно, в свою очередь, часть машинного обучения. Машинное обучение используется во многих, но не во всех подходах к искусственному интеллекту.
Виды обучения
| Вид | Что есть в данных | Типичная задача | Пример |
|---|---|---|---|
| С учителем | Объекты и правильные ответы | Предсказать число или категорию | Цена квартиры, письмо — спам или нет |
| Без учителя | Объекты без ответов | Найти группы и закономерности | Разбить погодные данные на сезоны |
| С подкреплением | Награды и штрафы за действия | Выработать стратегию действий | Научить робота ходить по комнате |
Google сравнивает обучение с учителем со студентом, который готовится по старым экзаменам с вопросами и ответами. Когда прорешано достаточно экзаменов, новый он сдаёт уверенно. Слово «с учителем» значит лишь то, что человек дал модели данные с известными верными ответами.
Основных задач с учителем две. Регрессия предсказывает число: количество осадков, цену дома, время в пути. Классификация относит объект к категории: «спам или не спам», «есть ли на фото кошка». Если вариантов два, классификация бинарная, если больше — многоклассовая.
Обучение без учителя чаще всего решает кластеризацию: группирует похожие объекты. В отличие от классификации, названия групп заранее не заданы, их присваивает человек, когда разглядит, что в них общего.
Простой пример на Python
Возьмём учебную задачу: предсказать цену квартиры по площади. Данные мы сгенерировали сами, поэтому цифры вымышленные и служат только для показа идеи. Сравним две модели: прямую, найденную методом наименьших квадратов, и «зубрилу», который отвечает ценой ближайшей по площади квартиры из обучающей выборки. Часть данных откладываем и показываем моделям только при проверке.
import random

random.seed(7)
# Учебные данные: площадь квартиры (м²) и цена (тыс. руб.). Цена зависит от площади плюс случайный «шум».
данные = []
for _ in range(60):
    площадь = random.uniform(25, 90)
    цена = 150 * площадь + random.gauss(0, 600)
    данные.append((площадь, цена))

random.shuffle(данные)
обучение, проверка = данные[:45], данные[45:]

def ошибка(модель, выборка):
    return sum(abs(модель(x) - y) for x, y in выборка) / len(выборка)

# Модель 1: прямая y = a*x + b, коэффициенты по методу наименьших квадратов
n = len(обучение)
mx = sum(x for x, _ in обучение) / n
my = sum(y for _, y in обучение) / n
a = sum((x - mx) * (y - my) for x, y in обучение) / sum((x - mx) ** 2 for x, _ in обучение)
b = my - a * mx
прямая = lambda x: a * x + b

# Модель 2: «зубрила» — отвечает ценой ближайшей квартиры из обучающей выборки
зубрила = lambda x: min(обучение, key=lambda p: abs(p[0] - x))[1]

print(f"прямая: цена = {a:.1f} * площадь {b:+.0f}")
for имя, модель in [("прямая", прямая), ("зубрила", зубрила)]:
    print(f"{имя:8} ошибка на обучении: {ошибка(модель, обучение):6.0f}   на проверке: {ошибка(модель, проверка):6.0f}")
Вывод при запуске на Python 3.13.12:
прямая: цена = 157.6 * площадь -460
прямая   ошибка на обучении:    436   на проверке:    507
зубрила  ошибка на обучении:      0   на проверке:    794
Модель «зубрила» не ошибается на примерах, которые видела, но на новых данных ошибается заметно больше прямой. Прямая допускает похожую ошибку и там, и там. Это и есть главный урок проверки.
Как понять, что модель обучилась хорошо
Если ошибка на обучающих данных мала, а на новых велика, модель заучила данные, а не нашла закономерность. Это называют переобучением. Поэтому данные делят на обучающую и проверочную части. В «Учебнике по машинному обучению» Яндекса оценка качества моделей, метрики и кросс-валидация вынесены в отдельный раздел.
Условия и ограничения
- Версия
- Октябрь 2026 — данные приведены на дату написания; код проверен на Python 3.13.12.
- Данные
- Качество результата — модель не может быть лучше данных, на которых она училась.
- Задача
- Вид обучения — выбирают по виду задачи и по тому, есть ли в данных правильные ответы.
- Проверка
- Новые данные — оценивать нужно на данных, которых модель не видела.
- Пример
- Учебные данные — цифры в примере сгенерированы и не отражают реальный рынок.
Частые ошибки
- Проверяют модель на тех же данных, на которых её учили.
- Берут слишком мало данных и делают выводы по случайным закономерностям.
- Не замечают, что данные смещены: модель повторит перекос, который в них есть.
- Верят одной цифре точности без вопроса, на каких данных она получена.
- Берут сложную модель там, где хватило бы простой.
- Путают корреляцию и причину: связь в данных не доказывает, что одно вызывает другое.
Короткий вывод
Машинное обучение даёт программе самой найти правила в данных. Вид обучения зависит от того, есть ли в данных верные ответы. Главное правило проверки простое: оценивайте модель на данных, которых она не видела. Если захотите разобраться глубже, откройте «Учебник по машинному обучению» Школы анализа данных Яндекса: он написан на русском языке.